stream-it 使用指南
AI-driven development workflow — from PRD to shipped code
Usage Guide — 六步闭环研发工作流:规划、设计、拆解、实现、审查、交付。
目录
- 1. 概述
- 2. 安装
- 3. 工作流总览
- 4. Step 1: /prd — 需求规划
- 5. Step 1.5: /prd-to-spec — PRD 转技术方案
- 6. Step 1.6: /to-issues — 拆解 Issue 卡片
- 7. Step 2: /implement · /loop-it · /graph — 功能实现
- 8. Step 3: /review-it — 代码审查
- 9. Step 4: /ship-it — 提交交付
- 10. Bonus: /humanize-it — 去 AI 味改写
- 11. Bonus: /insight-diagram — UML 与架构图
- 12. Bonus: /refactor — 专家级代码重构
- 13. Bonus: /modern-go — Go 代码现代化改造
- 14. Bonus: /note-it — 实现笔记记录
- 15. Bonus: /walkthrough — 交付前走查
- 16. Bonus: /code-to-spec — 逆向生成规格文档
- 17. Bonus: /smell — 架构坏味道检测
- 18. Bonus: /loop-it — 自动化 Issue 批量实现循环
- 19. Bonus: /to-design — PRD 转设计文档
- 20. Bonus: /graph — 任务图并发实现
- 21. Bonus: /understand — 交互式变更审阅
- 22. Bonus: /ask-flow — 不知道该用哪个技能
- 23. Bonus: /triage — 外部 issue 分诊
- 24. Bonus: /diagnose — 排障循环
- 25. Bonus: /conflict — 解 merge / rebase 冲突
- 26. FAQ
1. 概述
stream-it 是一套研发工作流技能集:26 个技能,把「想法 → 交付」拆成标准步骤——需求、设计、拆解、实现、审查、交付——每一步由一个技能负责。
它让 AI Agent 能够像一个有经验的工程师一样——从理解需求、拆解任务、编写代码、审查质量,到最终提交合入——全流程自主完成。你只需描述功能想法,剩下的交给工作流。
/ask-flow——说清你现在的处境(一个还没成形的想法、一堆进来的 issue、一段调不通的代码、一次漫长的实现),它只回答「下一步敲什么」以及那一步里哪些决定要你来拍,不替你动手。
/ask-flow
技能路由(入口):只给下一步,不执行
- 在技能图上做路由,回答「下一步敲什么」
- 只建议、不执行:不写 spec、不改文件
- 不进模型目录(user-only)
/prd
需求文档生成
- 澄清问题 → 结构化 PRD(可验证的验收标准)
- 审阅确认后保存到 tasks/prd-*.md
- 交给 /prd-to-spec(可选)与 /to-issues 继续
/prd-to-spec
PRD 转技术设计方案
- PRD 需求 → 架构 + API + 数据模型
- 错误处理 + 安全 + 性能策略
- Issue 映射 + 实施计划
/to-issues
拆解 PRD/SPEC 为垂直切片 Issue
- 垂直切片(tracer bullet),非按层拆分
- 显式依赖边 + 阻塞者优先创建
- 支持 GitHub / Local,可独立使用
/triage
把外面进来的原始 issue 分流成可执行卡片
- 复现 / 理解 → 定角色(ready / needs-info / bug-confirmed / duplicate / wontfix)
- 把 ready 的补成 agent 可执行卡片
- 只处理外部条目,不 triage /to-issues 的产出
/goal
DSH 的持久目标命令
- 由人类在命令行输入;模型侧是 create_goal / update_goal
- 持久目标 + 自动续跑轮次
- 只在顶层直接的人类回合执行,不是 skill,也不是流水线步骤
/review-it
双轴代码审查收尾
- Spec 轴:diff 有没有做「要求的事」(缺的 / 多做的 / 做错的)
- Standards 轴:8 个维度查代码质量
- 两轴分开报告;按波 / 批调用一次
/ship-it
提交 → PR → 合入 → 关闭
- Commit 关联 Issue 编号
- Squash merge + delete branch
- 添加实现总结并关闭卡片
/understand
交互式审阅新生成的(AI)改动
- 把未提交 / 分支变更扫描成网页
- 文件树 + 语法高亮 diff + 逐段注释
- 每段配上对应单位需求与代码解释
/humanize-it
迭代式去 AI 味改写
- 自动选择最佳人性化策略
- 三路 skill 迭代直到达标
- 最多 42 轮智能切换
/insight-diagram
UML 与架构图生成器
- 分析代码库结构
- UML / 架构图 / 流程图
- 渲染为 HTML+SVG
/refactor
专家级代码重构
- 22 种代码坏味道识别
- 40+ 种重构手法 (Fowler 目录)
- 五阶段安全协议
/modern-go
Go 代码现代化改造
- 35+ 条 gofix 风格转换规则
- Go 1.0 到 1.27+ 全覆盖
- 自动检测版本 + 安全保护
/note-it
实现笔记记录
- 设计决策 / 偏离 / 权衡
- 待确认问题追踪
- 保存为 Markdown:
docs/issue#NNNN.md
/walkthrough
交付前走查
- 变更摘要 + 真实验证输出
- demo 路径的视觉证据
- 评审闸门:diff stat / PR 草稿 / 合并清单
/code-to-spec
逆向生成项目规格文档
- 分析代码、配置、测试、结构
- 生成 12 章节完整 SPEC
- 支持多层深度分析
/smell
架构坏味道检测
- 8 大类、50+ 反模式和坏味道
- 涵盖架构、耦合、内聚、设计、代码、测试、命名、复杂度
- 输出详细 Markdown 报告与重构路线图
/loop-it
自动化 Issue 批量实现循环
- 获取 Issue → 依赖拓扑排序 → 内联实现 → commit;批末统一评审、走查 + 交付
- 检查点恢复(
.loop-state.json),crash 不丢进度 - 10 类错误分类,结构化恢复策略
/to-design
PRD 转设计文档(Go 提案风格)
- 输出"为什么这么做"的决策文档
- 主动列出被放弃的方案及理由
- 区别于 SPEC:是决策文档而非实现契约
/graph
任务图并发实现(DAG + 超步)
- 任务/PRD → DAG → 分层为超步 wave
- 每波独立节点由子代理并发实现
- 每节点独立 worktree:内联实现 → commit;波末统一评审、走查 + 交付
/implement
单个单元的内联闭环
- 内联实现 → 项目门禁自证 → /review-it → /ship-it
- 不建 worktree、不派子代理、不建波分支
- 只做一个单元,不扩张范围
/test-first
红 → 绿循环的参考
- 好测试:通过公开接口验证行为
- 接缝要预先与用户约定
- 三个反模式 + 循环规则(红先于绿、一次一片)
/diagnose
难 bug 的排障循环
- 先拿到一条已经在「这个」bug 上变红的命令
- 最小化复现 → 3–5 条可证伪假设 → 一次一个变量地埋点
- 在正确的接缝上补回归测试;不做 review / ship
/conflict
解进行中的 merge / rebase 冲突
- 查清两边意图 → 逐 hunk 解(能同留就都留)
- 跑项目门禁,把这次操作做完
- 永远解,绝不
--abort
/design-it
固定风格的 HTML 设计文档
- 需求/规格 → 单文件 HTML 设计文档
- 目录 + 架构/序列 SVG + 代码块
- 决策面板 + 测试用例 + 代码索引
/listenhub-tts
ListenHub 文本转语音(TTS)
- 快速合成 / 多角色脚本 / 长文本流式
- 音色未指定时自动获取音色列表
- 默认音色 chat-girl-105-cn(晓曼)
/article-icons
为文章配 itshover 风格图标
- 抓取图标并转为干净的内联 SVG
- 布置在标题、要点、列表与标注处
- 适用于 Markdown / HTML 文档
- 唯一会在运行时访问第三方服务的技能(
itshover.com):请求限定在该域名,返回的标记按白名单重建后才内联,异常即报错不输出
flow(流水线本身,10 个)、practice(中途因为出事了或要保证质量伸手拿的,7 个)、meta(描述这套技能集自身的路由,1 个)、bonus(产出非代码工件,8 个)。
2. 安装
两条安装路径,二选一即可。
方式一(推荐):作为 skill 目录安装
# 安装全部 skills 到 ~/.agents/skills
npx skills add 9Ashwin/stream-it

# 之后按来源更新
npx skills update -g- skills 落到
~/.agents/skills,这条装法不必动任何 profile 依赖。 npx skills递归扫描,安装时把skills/<桶>/<技能>拍平成~/.agents/skills/<技能>——技能根只扫一层,所以必须拍平。- 选择技能时按桶分成 4 组(flow / practice / meta / bonus),不是 26 项平铺:分组来自
.claude-plugin/marketplace.json里「每桶一个 plugin」的声明;没有归属声明的技能会掉进兜底的Other组。 - 这是最省事的一条路:不必动 profile 的依赖,对所有 profile 都生效。
手动拷贝时要自己完成拍平这一步——不要连桶一起拷:
# 拍平到 ~/.agents/skills/<技能>
cp -R <stream-it>/skills/flow/graph ~/.agents/skills/graph
方式二(可选):作为 bundle 安装
# 安装到 web profile
dsh plugin --profile web add -w github:9Ashwin/stream-it

# 生产环境建议锁定到某个 commit
dsh plugin --profile web add -w github:9Ashwin/stream-it#<sha>

# 验证安装
dsh --profile web --dump-config | grep -A3 stream-it-w不能省略:DSH 把 profile 当作 pnpm workspace 根,pnpm 9 缺少该标志时会报ERR_PNPM_ADDING_TO_ROOT。- 包里的
dsh.bundle声明会让dsh把它追加进 profile 的bundles层,技能由包内自带的 provider 提供,不依赖~/.agents/skills是否在技能根里。 - 本包是 config-only bundle(纯配置包,没有构建脚本),因此不需要
allowBuilds授权。 - 生产环境建议锁定 commit:
github:9Ashwin/stream-it#<sha>。 - 验证:
dsh --profile web --dump-config | grep -A3 stream-it,应看到# == stream-it-skills层。 - 本地 checkout 联调:
dsh plugin --profile demo add -w /path/to/stream-it。
~/.agents/skills 本来就在它的技能根里,所以「只想要技能」时方式一就够了——两个来源的同名技能按近层优先去重,目录副本会赢过插件包副本,两条都装也不会重复出现,只是在 Web 面上 bundle 赢不了目录。方式二的增量价值是随包携带 preset:一个 preset 可以同时决定这个 agent 挂哪些技能、以及它的子代理带不带技能目录(toolFilter)与 persona,把「这套流程怎么跑」变成部署层的一等配置。反过来,若你用没挂 preset 的面(某些 minimal profile),方式二才是技能可见的来源。
前置要求
| 工具 | 用途 | 安装 |
|---|---|---|
npx | npm package runner(推荐方式) | Node.js 自带 |
gh | GitHub CLI (Issue/PR 操作) | brew install gh && gh auth login |
dsh | DeepSeek Harness CLI(仅方式二需要) | 参见 DSH 官方安装说明 |
/ask-flow、/prd、/prd-to-spec、/to-issues、/triage、/implement、/test-first、/loop-it、/graph、/diagnose、/conflict、/review-it、/ship-it、/refactor、/modern-go、/note-it、/walkthrough、/code-to-spec、/humanize-it、/insight-diagram、/smell、/to-design、/design-it、/listenhub-tts、/article-icons、/understand 即可直接调用对应技能。其中 /goal 是 DSH 的命令(不是 skill):模型侧是 create_goal / update_goal,但只在顶层直接的人类回合执行。
/ask-flow、/insight-diagram、/article-icons、/humanize-it、/listenhub-tts)标记为不进模型目录,省下每个会话与每个子代理都要付的那份固定成本。这 5 个技能还各带一份 agents/openai.yaml(policy.allow_implicit_invocation: false)。
3. 工作流总览
从需求到交付的闭环工作流:
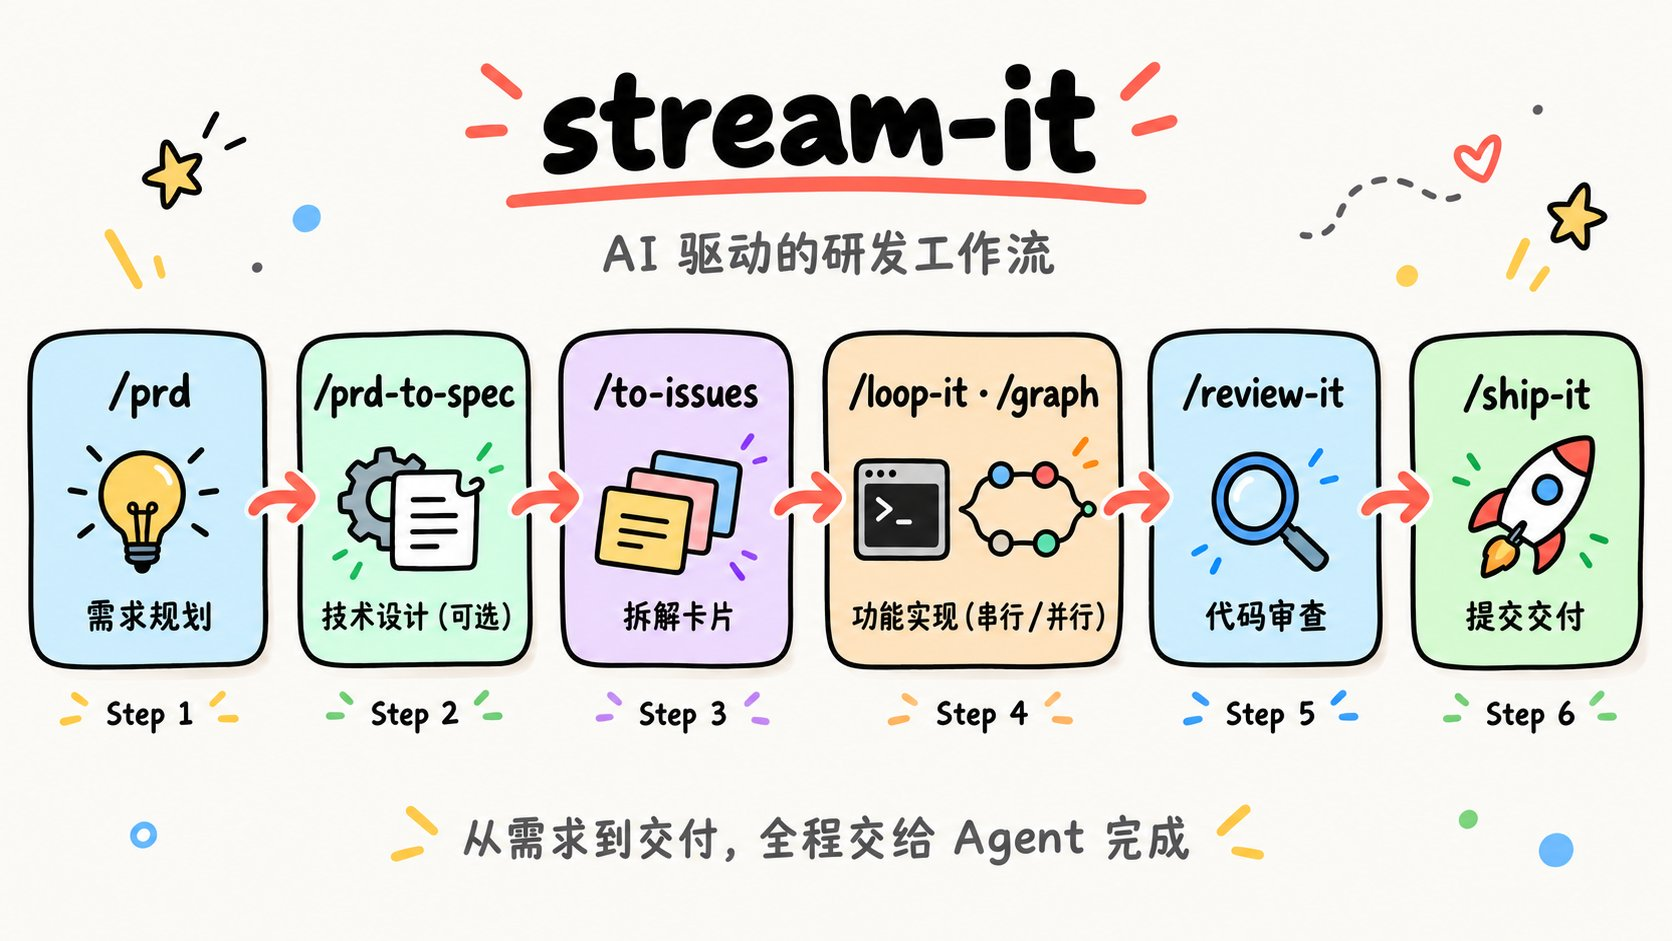
/prd → /prd-to-spec (可选) → /to-issues ─┬─→ /implement  (单单元:内联实现 → 门禁自证 → /review-it → /ship-it)
                                             ├─→ /loop-it    (串行:一次一个 Issue,带检查点恢复)
                                             └─→ /graph      (并行:按波次 fan-out,每节点独立 git worktree,波次间 fan-in 屏障)
节点:内联实现 → 门禁自证 → commit;波末:集成 → /review-it → /walkthrough → /ship-it| 步骤 | 命令 | 输入 | 输出 |
|---|---|---|---|
| 1. 规划 | /prd |
功能描述 / 产品想法 | PRD 文档(交给 /to-issues 拆解) |
| 1.5 设计 | /prd-to-spec |
PRD 文档 | 技术 SPEC(可选) |
| 1.6 拆解 | /to-issues |
PRD / SPEC 文档 | Issue 卡片 |
| 2. 实现 | /implement / /loop-it / /graph |
一个或多个 Issue 卡片 | 可运行的代码实现 |
| 2.5 笔记 | /note-it |
已实现并审查的变更 | docs/issue#NNNN.md 实现笔记(可选) |
| 3. 审查 | /review-it |
代码变更 (dirty / branch) | 通过审查的干净代码 |
| 3.5 走查 | /walkthrough |
已评审的变更 | tasks/walkthrough-<feature>.md 走查文档(可选) |
| 4. 交付 | /ship-it |
已审查的代码 | 已合入的 PR + 已关闭的 Issue |
/implement,有 bug / 偶发 flake / 性能回归先 /diagnose,外面进来的原始 issue 先 /triage,正在解 merge / rebase 冲突用 /conflict。选不准就敲 /ask-flow。
4. Step 1: /prd — 需求规划
/prd 将一个模糊的功能想法转化为结构化的产品需求文档(PRD):先把歧义问清楚,再把需求写成可验证的验收条件。它只产出 PRD,不拆 Issue——拆解交给 /to-issues。
触发方式
# 直接输入
/prd 给我们的任务管理系统加一个优先级功能

# 或使用触发词
写PRD:用户注册功能,支持邮箱和手机号
需求分析:为 API 增加限流能力
工作流程
- Agent 提出澄清问题(带字母选项,可快速回复 "1A, 2C, 3B"),数量随复杂度伸缩,不凑数
- 根据回答生成结构化 PRD(用户故事、功能需求、非目标、验收标准)
- 展示 PRD 供审阅,确认或调整
- 保存 PRD 到
tasks/prd-[feature-name].md - 建议下一步:
/prd-to-spec(可选)与/to-issues
输出示例
# 保存 PRD 后给出的下一步
✅ PRD saved to tasks/prd-priority-system.md

/prd-to-spec  (可选:复杂功能才需要技术方案)
/to-issues (把 PRD 拆成有阻塞关系的 Issue)/review-it 的 Spec 轴能证伪的依据。Issue 粒度由 /to-issues 负责:一个 Issue 应是单个 Agent 在单次会话里能完成的量(通常 1-3 个文件)。
5. Step 1.5: /prd-to-spec — PRD 转技术方案
/prd-to-spec 将产品需求文档(PRD)转化为可实施的技术设计方案(SPEC)。PRD 说明"做什么",SPEC 说明"怎么做"。
触发方式
# 直接输入
/prd-to-spec tasks/prd-priority-system.md

# 或使用触发词
需求转设计:将优先级 PRD 转为技术方案
技术方案:基于 prd-user-auth.md 生成 SPEC
PRD → SPEC 映射
| PRD 元素 | SPEC 章节 | 转化方式 |
|---|---|---|
| User Stories | 业务逻辑 + 测试映射 | 故事 → 算法 + 测试用例 |
| Functional Requirements | API 设计 + 业务逻辑 | FR → 端点 + 实现逻辑 |
| Acceptance Criteria | 测试策略 | 标准 → 具体测试场景 |
| Non-Goals | 开放问题 | 明确排除范围 |
| Technical Considerations | 架构 + 性能 | 约束 → 设计决策 |
SPEC 输出结构(11 章节)
| # | 章节 | 内容 |
|---|---|---|
| 1 | Summary | 覆盖范围、PRD 引用、设计决策摘要 |
| 2 | Architecture | 系统上下文、组件设计、文件结构 |
| 3 | Data Model | Schema 变更、实体定义、迁移计划 |
| 4 | API Design | 端点表、请求响应 Schema、错误响应 |
| 5 | Business Logic | 核心算法、校验规则、状态机、边界情况 |
| 6 | Error Handling | 错误分类、重试策略、降级方案 |
| 7 | Security | 认证授权、输入校验、数据保护 |
| 8 | Performance | 预期负载、优化策略、数据库考量 |
| 9 | Testing Strategy | 单元/集成/E2E 测试 + 验收标准映射 |
| 10 | Implementation Plan | 实施阶段、Issue 映射、渐进交付 |
| 11 | Open Questions & Risks | 未决问题、技术风险、假设前提 |
工作流程
- 定位 PRD 文件(自动扫描 tasks/ 或手动指定)
- (可选)分析现有代码库:架构、技术栈、模式、约定(无代码库时跳过,从零提出架构)
- 提出 3-5 个技术澄清问题(带选项)
- 生成完整 SPEC 文档
- 展示供审阅,确认或迭代
- 保存到
tasks/spec-[feature-name].md
/prd-to-spec 是一个可选步骤。对于大多数中小型功能,PRD 中的 Functional Requirements 和 Acceptance Criteria 已经足够让 AI agent 在实现阶段自主做出技术决策——agent 会自动分析代码库、理解架构、选择合适的实现路径,不需要一份预先写好的 SPEC。仅在以下场景才建议先跑 /prd-to-spec:
- 多人或多 agent 并行开发,需要共享技术约定
- 跨多个服务/模块的大型改动,架构决策影响面大
- 团队有合规或评审流程要求设计文档
- PRD 写得较模糊,需要提前补足技术细节降低理解偏差
6. Step 1.6: /to-issues — 拆解 Issue 卡片
/to-issues 将 PRD 和/或 SPEC 拆解为垂直切片的可独立实施 Issue,并创建到你选择的平台。可独立使用,不需要先运行 /prd。
触发方式
# 直接输入
/to-issues

# 或使用触发词
创建issue:基于 prd-user-auth.md 创建 Issue
拆解issue:从 SPEC 拆解可实施的卡片
生成卡片:将 PRD 和 SPEC 一起拆成 Issue
输入来源
| 选项 | 说明 |
|---|---|
| 自动检测 | 扫描 tasks/ 目录,列出可用的 PRD 和 SPEC |
| 指定 PRD | 只基于 PRD 的 User Stories 拆解 |
| 指定 SPEC | 使用 SPEC 的 Issue Mapping 章节作为主指导 |
| PRD + SPEC | (推荐)PRD 提供需求,SPEC 提供技术约定,Issue 最完整 |
创建平台
| 平台 | 工具 | 说明 |
|---|---|---|
| GitHub | gh issue create | 原生依赖边 --blocked-by、子 issue --parent(需 gh v2.94+) |
| Local | Markdown 文件 | 一 Issue 一文件、按依赖排序,存于 per-feature 目录 |
工作流程
- 定位输入文件(自动检测或手动指定 PRD/SPEC)
- 先识别 prefactoring("让改动变简单"的铺垫工作),排在最前
- 拆解为垂直切片 Issue,标注 demo path 与显式 Blocked by 依赖边,按依赖顺序编号
- quiz 用户复核:粒度、依赖边、demo path 是否为行为而非某一层
- 选择创建平台(GitHub / Local)
- 阻塞者优先创建,逐条落地并输出汇总报告(含可立即开始的 frontier)
expand → migrate → contract 序列,作为垂直切片规则的唯一例外。
/to-issues 是从需求到实现的关键桥梁。它可以独立使用——即使你没有用 /prd 生成 PRD,只要有一个需求文档(甚至直接粘贴),就能拆出 Issue。
边界:/triage 只管从外面进来的条目
/to-issues 拆的是你自己的需求,产出已经是 agent-ready 的卡片;从外面进来的 bug 报告、用户反馈、别人提的需求归 /triage——先复现 / 理解,再定角色(ready / needs-info / bug-confirmed / duplicate / wontfix),并把 ready 的补成 agent 可执行的卡片。不要 triage /to-issues 产出的卡片。详见 22. /triage。
7. Step 2: /implement · /loop-it · /graph — 功能实现
实现步骤由正在运行的 agent 内联完成:它读取 Issue 的标题、正文与验收标准(含其中引用的 PRD/SPEC),自己写代码、跑测试与 lint,直到验收条件全部满足。技能提供三条实现路线:只有一个单元时内联走 /implement,串行走 /loop-it,并行走 /graph。
/goal 不再是流水线步骤。在 DSH 中,/goal 是命令而不是 skill——由人类在命令行输入,创建一个带自动续跑轮次的持久目标。这条能力的模型侧是 create_goal / update_goal,但 create_goal 只在顶层直接的人类回合执行:子代理铸造不了长期目标,技能在编排中途也不行。因此「实现 Issue」这一步由 agent 内联完成,而不是调用 /goal。若想要一个自动续跑的长目标,应由人类自己输入 /goal <objective>。
/implement — 单单元内联闭环
一条 issue、一张卡片、spec 里的一项——只有一个单元时走这条路,闭环是:内联实现 → 项目门禁自证 → /review-it → /ship-it。它明确不建 worktree、不派子代理、不建波分支——那些是 /loop-it 与 /graph 的编排,单点上图或开循环只是多付编排成本。
- 先读清这个单元:把验收条件逐条列出来,读它引用的 PRD / SPEC / 设计文档,再读相邻代码与现有测试,让命名、错误处理与日志风格和仓库一致
- 就跑项目自己的门禁自证(
mise run check、go build ./... && go test ./...、pnpm --dir web lint…):边写边跑相关单测,最后跑一次全量;没被测过的验收条件不算满足 - 不扩张范围:不 force-push,不替用户拍含糊的验收条件(先问清楚),不把范围外的顺手改动塞进这份 diff(要改就另开一条)
参考:/test-first — 红 → 绿
需要先把行为定下来再写实现时用它:一个测试 → 一段实现 → 再一个测试,一次一个接缝。它同样是 /implement 内部会用到的参考,可以单独调用。
- 接缝要预先与用户约定:写任何测试之前,先把「要测哪些接缝」写下来并与用户确认——测不了所有东西,先约定接缝,精力才会落在关键路径与复杂逻辑上
- 三个反模式:与实现耦合(mock 内部协作者、测私有方法、从侧信道验证)、同义反复(期望值用与实现相同的方式重算,于是按构造就通过)、横向切片(先把所有测试写完,测的是想象出来的形状而非面向用户的行为)
- 循环规则:红先于绿(先写失败测试,再写刚好让它通过的最少代码)、一次一片(一轮 = 一个接缝 + 一个测试 + 一个最小实现)、重构不属于这个循环(它属于
/review-it)
节点作用域:实现 → 自证 → 只 commit
- 每个节点独享一个 git worktree 与自己的分支
feat/node-{N}-{slug},所有编辑都发生在该 worktree 内 - 实现完成后,在自己的 worktree 内跑目标项目的门禁自证(如
go build ./...、go test ./...、mise run check),没有测到的验收条件不算满足 - 只 commit 到自己的分支:不 push、不开 PR、不合并,也不自审——节点的报告是证据而不是结论
/loop-it — 串行实现
- 获取仓库中所有打开的 GitHub Issue
- 解析 Issue 正文里的依赖关系,做依赖感知的拓扑排序,得到可安全开始的顺序
- 一次一个 Issue 内联实现(读需求 → 写代码 → 跑门禁自证),在该 Issue 自己的分支上 commit;不 push、不开 PR
- 批末把各 Issue 分支汇总成一条批次分支(不并入 failed 的分支),只做一次
/review-it、一次/walkthrough与一次/ship-it - 每次状态变更立即写入
.loop-state.json检查点,崩溃或中断后可从断点恢复
适合节点之间大量共享文件、必须串行保证安全的场景;一次只处理一个 Issue。批末 PR 关闭多个 Issue,需按逐项证据表列出每项的 commit、关闭编号、验收证据与人工验收状态。
/graph — 并行实现
- 把一个任务(或 PRD / SPEC / Issue 集合)转化为有向无环图(DAG),按依赖关系分层为若干波次(wave)
- 每个波次里相互独立的节点由一个子代理 并发实现,每个节点独占一个 git worktree,并行编辑互不污染工作树
- 节点只 commit 到自己的分支;波次之间设强制 fan-in 屏障(BSP 语义)——等齐本波所有节点的完成通知后才收尾
- 屏障到达后统一收尾:泄漏检查 → 集成(只合并 shipped 的节点,failed 的绝不合并)→ 在集成后的树上跑门禁 → 评审一次(逐节点分节)→ ship 一次(一个 PR,关闭该波满足的 Issue)
- 每波写入
.graph_state.json检查点,并据此重新渲染graph.html实时看板
适合 DAG 中存在真正并行度(相互独立的子系统)的场景。单节点波没有可集成的对象,跳过 wave 分支与 merge 仪式,直接对该节点分支 review + ship。详见 17. /loop-it 与 19. /graph。
失败节点:原地重试 → 重跑 → 剔除
- 先用继续消息复用该节点的上下文原地重试;仍失败再考虑作为新节点重跑,最后才剔除
- 其依赖节点标记为 blocked;其余兄弟节点照常 ship——波不是全有全无,但 failed 的分支永不合并,也不为推进波次而谎报 shipped
/implement(内联实现 → 门禁自证 → /review-it → /ship-it,不建 worktree、不派子代理);/goal 是 DSH 的命令而不是 skill:模型侧是 create_goal / update_goal,但 create_goal 只在顶层直接的人类回合执行——子代理和编排中途都铸造不了长期目标;/review-it、/ship-it 是真实 skill,由编排器在波级各调用一次。子代理要付出父级完整 prompt、工具 schema 与技能目录的固定成本,所以节点止于 commit、琐碎工作内联做;并发上限默认 3–4,波内节点数建议 2–3。
8. Step 3: /review-it — 代码审查
/review-it 是提交前的审查收尾:先跑门禁自证,再评审 diff,发现真实问题并迭代修复,直到没有可操作的发现。在当前契约里它按波 / 批调用一次,审的是集成后的 diff,而不是每个节点各自审自己刚写完的代码。
双轴:Spec 与 Standards,分开报告
每次评审回答两个不同的问题,分成两节报告,绝不合并成一张排序表——一旦合并,「命名与风格」的意见就会把「漏掉一条验收条件」淹没掉:
- Spec 轴 — 这份 diff 有没有做「要求的事」?先找到规格再读 diff:commit message 里的 issue 编号(
gh issue view <n>)、用户给的路径、或对应的tasks/prd-*.md/tasks/spec-*.md/docs/*.md;都不存在就说明「没有规格」,对着用户明确说过的要求审,不要发明需求。三种查法:要求了但缺的 / 没人要求却多做的 / 形状对但做错的。每条发现都要引用它对应的验收条件,才可证伪而不是偏好。 - Standards 轴 — 这份代码在本仓库里算不算好?即下面 8 个维度,按严重程度排序。
| # | 维度 | 看什么 |
|---|---|---|
| 1 | 隐藏副作用 | 是否在非显而易见的地方产生级联影响、改了共享状态或外部依赖的行为 |
| 2 | 破坏兼容性 | API 签名、数据结构、配置文件格式、命令行接口是否被改,现有调用方是否受影响 |
| 3 | 边界情况 | null / 空值 / 空集合、极大极小值、并发竞态、异常路径 |
| 4 | 性能风险 | 嵌套循环、N+1 查询、大对象分配、阻塞 I/O、锁竞争 |
| 5 | 安全风险 | 注入、越权、敏感信息泄露、不安全反序列化、依赖漏洞 |
| 6 | 命名误导 | 名字与实际行为不符、名不副实或语义模糊 |
| 7 | 测试不足 | 关键路径、边界条件、错误处理是否缺覆盖,现有测试是否真的验证了期望行为 |
| 8 | 未来维护成本 | 不必要的抽象、重复代码、隐式耦合、难追踪的控制流 |
评审路径
没有外部 review CLI——/review-it 加载后,由正在运行的 agent 亲自按下面的审查原则审当前 diff,不会 shell out 任何 review 命令。
# 未提交变更(默认):直接审工作树,含未跟踪文件
git status --short
git diff
git diff --cached

# 分支 / PR:先生成相对 base 的 diff,再逐段审
# base 取 PR 的 base,否则取仓库默认分支——不写死 main
base=$(gh pr view --json baseRefName --jq .baseRefName 2>/dev/null || git symbolic-ref -q --short refs/remotes/origin/HEAD | sed 's|^origin/||')
diff_file=$(mktemp)  # 固定 /tmp 名可被预创建,别用
git diff "origin/$base"...HEAD > "$diff_file"
diff 较大、或更看重独立性时,可把 diff 文件交给一个全新的子代理审——它看不到本会话的上下文,因此提示词必须自包含。
审查原则
| 原则 | 说明 |
|---|---|
| Advisory | 审查结果视为建议,不盲目应用 |
| Verify | 每个发现都通过读取真实代码路径验证 |
| Reject noise | 拒绝不切实际的边界情况、投机性风险、过度重构 |
| Iterate | 修复后重新审查,直到无可操作发现 |
| Minimal | 优先小修复,不做不必要的大重构 |
审查模式
| 工作树状态 | 模式 | 操作 |
|---|---|---|
| 有未提交变更 | local | 由当前 agent 直接审查工作树(含未跟踪文件) |
| 已提交未推送 | branch | git diff origin/main...HEAD + 审这份 diff |
| 已推送 / PR | branch | 同上,相对的 base 用 PR 的实际 base |
| 干净工作树 | skip | 确实没有可审的内容时跳过 |
波级评审:一次、逐节点分节
- 评审对象是集成后的树:
/graph一波审git diff main...wave-{K}-{slug}(单节点波直接审该节点分支);/loop-it一批审批末汇总出的批次分支 - 按计划顺序逐节点 / 逐 issue 分节读,重点看节点之间的结合部——共享接口、装配文件、配置与状态;这是逐节点自审结构上看不到的一类缺陷
- 这是这一波唯一的评审:绝不跳过,也绝不让某一个特性的小节吃掉整个 pass
- 采纳的发现先修复,再在集成后的树上重跑门禁,直到没有可操作的发现
references/other-clis.md。
9. Step 4: /ship-it — 提交交付
/ship-it 是实现完成后的标准收尾流程:提交代码、创建 PR、合入、添加实现总结、关闭 Issue。在 /graph 一波或 /loop-it 一批的收尾里,它只调用一次:一个分支、一个 PR、一次 CI、一次 merge,关闭该波 / 该批满足的多个 Issue。
触发方式
# 直接调用
/ship-it

# 或使用触发词
提交代码
创建PR并合入
完整流程
# Step 1: 提交代码(关联 Issue)
git add <related files>
git commit -m "Add priority field to database (#42)"

# Step 2: 推送分支
git push -u origin feat/issue-42-priority-field

# Step 3: 创建 PR(body 包含 Closes #42)
gh pr create --title "Add priority field" \
  --body "Closes #42 ..."

# Step 4: 合入
gh pr merge --squash --delete-branch

# Step 5: 关闭 Issue(如未自动关闭)
gh issue close 42 --reason completed
多个 issue 共用一个 PR(波 / 批末模式)
/graph 一波与 /loop-it 一批默认把多个 Issue 收进同一个 PR(squash 后只剩一个 commit)。此时 PR body 必须逐项列出证据,不能只写一行 Closes #1 #2 #3——否则单项特性既没法审计,也没法单独回滚。
| 项 | commit | 关闭的 issue | 验收证据(测试名 / 命令) | 人工验收 |
|---|---|---|---|---|
| 节点 3 | abc1234 | Closes #12 | TestFooBar | 尚未人工验收 |
| 节点 4 | def5678 | Closes #13 | mise run check + TestBaz | 尚未人工验收 |
- commit 列必填:squash 之后这些提交在
main上已经看不到,只有写进 PR body 才能按项追溯与回滚 - 验收证据要具体:写测试名或命令,不写「测试通过」
- 人工验收逐项标注:该项主路径没人走过就写「尚未人工验收」;只有用户明确确认后才能改,并注明确认依据(时间 / 环境)
- 逐项关闭 issue:每项各自写
Closes #N(或合入后手工关闭),不要合成一行 - 本 PR 由 N 项合并而成;squash 后如需撤销单项,按上表里的 commit 手工 revert
单项 PR(一个 Issue 一个 PR)不需要这张表,按上面的「完整流程」即可。
错误处理
| 场景 | 处理方式 |
|---|---|
| CI checks 失败 | 查看失败原因,修复后追加 commit 推送 |
| Merge conflict | 交给 /conflict 逐 hunk 按意图解,跑通项目门禁再收尾(绝不 --abort),解决后再 force push |
| Branch protection | 确认 required reviews 已满足 |
| Issue 未自动关闭 | 确认 PR body 包含 Closes #N,或手动关闭 |
/conflict——能同时保留两边意图就都保留,真不兼容时选与本次合并目标一致的一边并把权衡写进 commit message,永远解,不 --abort。详见 24. /conflict。
/ship-it 依赖 gh CLI。确保已通过 gh auth login 完成认证。
10. Bonus: /humanize-it — 去 AI 味改写
/humanize-it 对指定文档进行去 AI 味的改写。根据文档类型自动选择最合适的人性化策略,迭代改写直到效果达标。
触发方式
# 直接输入
/humanize-it docs/architecture.md

# 或使用触发词
去AI味:把这篇文档改成人话
降AIGC:humanize docs/blog-draft.md
子 Skill 能力矩阵
| Skill | 适用场景 | 改写风格 |
|---|---|---|
humanizer-zh | 通用文本、博客、文案 | 自然、有温度、带观点 |
humanize-chinese | 通用 + 学术 + 长文本 | 多风格(知乎/小红书/学术/文学等) |
technical-writing | 技术文档、架构说明、评审稿 | 平实、严谨、可论证 |
自动策略选择
| 文档类型 | 优先策略顺序 |
|---|---|
| 技术文档 | technical-writing → humanizer-zh → humanize-chinese |
| 学术论文 | humanize-chinese (academic) → humanizer-zh → technical-writing |
| 通用文本 | humanizer-zh → humanize-chinese → technical-writing |
| 长文本 (≥1500字) | humanize-chinese (longform) → humanizer-zh → technical-writing |
迭代机制
- 自动检测文档类型,选择第一个改写 skill
- 改写后按 5 个维度评分(AI 痕迹去除 / 自然度 / 信息完整 / 风格一致 / 可读性)
- 评分 ≥ 80 分则通过,输出结果
- 不达标则切换到下一个 skill,在上次改写基础上继续优化
- 同一 skill 连续 3 次无提升则自动切换
- 所有 skill 用完一轮后从头开始新一轮组合
- 最多迭代 42 轮,输出当前最佳结果
11. Bonus: /insight-diagram — UML 与架构图生成
/insight-diagram 为任意项目生成 UML 图、架构图和流程图。分析代码库后让用户选择要生成的图表类型,渲染为 HTML+SVG 并保存到 docs/ 目录。
触发方式
# 直接输入
/insight-diagram

# 或使用触发词
生成架构图:分析项目结构并生成架构图
画流程图:为这个模块绘制调用流程图
生成UML图:生成类图和时序图
支持的图表类型
共支持 17 种图表类型,分为结构性图形和行为性图形两大类:
结构性图形(静态)
| 编号 | 图表类型 | 关注点 |
|---|---|---|
| 1 | 系统架构图 ★ | 组件关系、全局视角(非UML,最常用) |
| 2 | 类图 | 定义类、属性、操作及关系 |
| 3 | 对象图 | 特定时刻的对象实例及其关系 |
| 4 | 组件图 | 系统组件及其依赖关系 |
| 5 | 部署图 | 物理硬件、节点及软件部署 |
| 6 | 包图 | 将模型元素分组组织 |
| 7 | 复合结构图 | 类的内部结构 |
| 8 | 剖面图 | 扩展UML元模型、自定义构造型 |
行为性图形(动态)
| 编号 | 图表类型 | 关注点 |
|---|---|---|
| 9 | 流程图 ★ | 主流程与分支(非UML,最常用) |
| 10 | 用例图 | 从用户角度展示系统功能 |
| 11 | 活动图 | 过程的流程或步骤 |
| 12 | 状态机图 | 对象生命周期的状态变迁 |
| 13 | 序列图 | 按时间顺序展示对象间交互 |
| 14 | 通信图 | 侧重于对象间的组织关系 |
| 15 | 定时图 | 侧重于状态变化的时间约束 |
| 16 | 交互概览图 | 结合活动图和时序图 |
| 17 | 泳道图 | 跨组件/角色职责流程(活动图变体) |
★ 标注为最常用的图表类型。默认推荐组合:架构图 + 序列图 + 流程图。
工作流程
- 分析项目代码库,识别关键组件和依赖关系
- 展示可选的图表类型列表,用户选择需要生成的类型
- 使用 architecture-diagram skill 渲染为 HTML+SVG
- 保存输出到
docs/目录
src/services/ 目录"、"重点分析数据库层",生成结果会更聚焦。
12. Bonus: /refactor — 专家级代码重构
/refactor 基于 Martin Fowler《重构》第 2 版的完整目录,提供专家级代码重构能力。通过识别代码坏味道并应用经过验证的重构手法,在不改变外部行为的前提下改善代码的可维护性、可读性和结构。
触发方式
# 直接输入
/refactor

# 或使用触发词
重构:重构 UserManager 类,它太大了
code smell:这个函数有 Feature Envy,修复它
extract method:把这个长方法拆分成更小的函数
代码坏味道目录
共识别 22 种代码坏味道,按五大类别组织:
| 类别 | 坏味道 | 主要重构手法 |
|---|---|---|
| 臃肿类 | 过长方法 | Extract Method, Replace Temp with Query |
| 过大的类 | Extract Class, Extract Subclass | |
| 基本类型偏执 | Replace Data Value with Object | |
| 过长参数列表 | Introduce Parameter Object | |
| 数据泥团 | Extract Class | |
| OO 滥用类 | Switch 语句 | Replace Conditional with Polymorphism |
| 临时字段 | Extract Class, Introduce Null Object | |
| 被拒绝的遗赠 | Replace Inheritance with Delegation | |
| 异曲同工的类 | Rename Method, Extract Superclass | |
| 变更阻碍类 | 发散式变化 | Extract Class |
| 霰弹式修改 | Move Method, Move Field | |
| 平行继承体系 | Move Method, Move Field | |
| 冗余类 | 注释(代码自说明) | Extract Method, Rename Variable |
| 重复代码 | Extract Method, Pull Up Method | |
| 冗赘类 | Inline Class, Collapse Hierarchy | |
| 纯数据类 | Move Method, Encapsulate Field | |
| 死代码 | 删除(Git 历史有记录) | |
| 夸夸其谈未来性 | Inline Class, Remove Parameter | |
| 耦合类 | 依恋情节 | Move Method |
| 狎昵关系 | Move Method, Move Field | |
| 消息链 | Hide Delegate | |
| 中间人 | Remove Middle Man | |
| 不完美的库类 | Introduce Foreign Method |
重构手法目录
40+ 种重构手法,分 6 大类,每种附带机械步骤和对比示例:
| 类别 | 手法数 | 代表性手法 |
|---|---|---|
| 组合方法 | 9 | Extract Method, Inline Method, Extract Variable, Replace Temp with Query, Substitute Algorithm |
| 移动特性 | 7 | Move Method, Move Field, Extract Class, Inline Class, Hide Delegate |
| 组织数据 | 13 | Replace Data Value with Object, Encapsulate Field, Replace Type Code with Subclasses, Replace Magic Number |
| 简化条件 | 8 | Decompose Conditional, Guard Clauses, Replace Conditional with Polymorphism, Introduce Null Object |
| 方法调用 | 13 | Rename Method, Separate Query from Modifier, Introduce Parameter Object, Replace Error Code with Exception |
| 泛化 | 9 | Pull Up Method, Push Down Method, Extract Interface, Form Template Method, Replace Inheritance with Delegation |
安全协议
- 准备阶段:编写特征测试 → 提交当前状态 → 创建重构分支
- 每一步:一次仅做一处变更 → 编译通过 → 所有测试通过 → 提交
- 验证阶段:全部测试通过 → 手动冒烟测试 → 自审 diff → 最终提交
- 铁律:不改变外部行为,不混杂功能变更,每一步都有测试保障
语言专属指南
| 语言 | 核心建议 |
|---|---|
| Java | final 局部变量、IDE 自动重构、Records、Sealed Classes |
| TypeScript | 解构减少参数、const 优先、Union Types 替代类型码、?. 消除 null 检查 |
| Python | Type Hints、dataclasses、@property、Context Managers |
| Go | 小接口、命名返回值、表格驱动测试、early returns 消除嵌套 |
| Rust | Result/Option 替代错误码和 null、Pattern Matching、From trait、Derive macros |
13. Bonus: /modern-go — Go 代码现代化改造
/modern-go 自动将 Go 代码升级为现代写法和 API,类似 go fix。扫描 go.mod 检测 Go 版本,对 Go 源文件批量应用版本适配的转换规则,覆盖从 Go 1.0 到 1.27+ 的 35+ 条规则。
触发方式
# 直接输入
/modern-go

# 或使用触发词
modernize:现代化改造这个项目的 Go 代码
升级Go代码:更新到 Go 1.22 的写法
gofix:扫描 pkg/ 目录并应用转换
工作流程
- 读取
go.mod获取 Go 版本 - 在目标范围内(指定文件/目录/整个项目)查找
.go文件 - 逐个文件扫描 "Before" 模式,应用所有版本 ≤ 项目版本的转换
- 每条转换附带简洁对照表和代码示例(before/after)
- 编辑完成后运行
goimports -w清理 import - 输出改造报告:文件数、应用转换数、已跳过的规则
转换规则目录(按 Go 版本)
| 版本 | 规则 | 示例(Before → After) |
|---|---|---|
| 1.0+ | time.Since | time.Now().Sub(start) → time.Since(start) |
| 1.8+ | time.Until | deadline.Sub(time.Now()) → time.Until(deadline) |
| 1.10+ | strings.Builder | 循环内 s += item → strings.Builder |
| 1.13+ | errors.Is | err == io.EOF → errors.Is(err, io.EOF) |
| 1.18+ | any, strings.Cut, bytes.Cut | interface{} → any, Index+切片 → Cut |
| 1.19+ | fmt.Appendf, 类型安全原子操作 | append(buf, fmt.Sprintf(...)...) → fmt.Appendf |
| 1.20+ | strings.Clone, CutPrefix/CutSuffix, errors.Join | string([]byte(s)) → strings.Clone(s) |
| 1.21+ | min/max, clear, slices/maps 包 | 手动循环 → slices.Contains, maps.Clone 等 |
| 1.22+ | range over int, cmp.Or, reflect.TypeFor | for i:=0;i<n;i++ → for i:=range n |
| 1.23+ | 迭代器 helpers, SplitSeq/FieldsSeq | for _,p:=range strings.Split(s,sep) → SplitSeq |
| 1.24+ | t.Context(), omitzero, b.Loop() | 测试中 context.Background() → t.Context() |
| 1.25+ | wg.Go() | wg.Add(1); go func(){defer wg.Done();fn()}() → wg.Go(fn) |
| 1.26+ | new(expr), errors.AsType | v:=42; &v → new(42) |
| 1.27+ | 内嵌字段字面量(embedlit)、go fix 自动化改造器 | 冗余的内嵌字段字面量 → 提升字段初始化 |
安全规则
omitzero仅建议不自动应用(可能改变 JSON 序列化行为)SplitSeq仅在循环体不需要索引或完整切片时应用strings.Builder仅当拼接发生在循环内时应用- 每次转换若需要新 import,自动添加并运行
goimports清理
/modern-go pkg/ 仅改造 pkg/ 目录,或 /modern-go main.go 仅改造单个文件。
14. Bonus: /note-it — 实现笔记记录
/note-it 在代码实现和审查完成后,为当前 Issue 生成一份结构化实现笔记,记录设计决策、偏离、权衡和待确认问题,输出为 HTML 格式保存到 docs/ 目录。
触发方式
# 直接输入
/note-it

# 或使用触发词
记录笔记:为 Issue #42 生成实现笔记
implementation notes:记录本次实现的决策和偏离
笔记内容
| 类别 | 关注点 | 示例 |
|---|---|---|
| Design Decisions | 规格模糊处的选择及理由 | 为什么选择接口多态而非 switch |
| Deviations | 有意偏离规格的地方及原因 | 简化了错误处理策略的理由 |
| Tradeoffs | 考虑的替代方案及取舍分析 | 内联 vs 提取函数的选择 |
| Open Questions | 需要确认或修改的事项 | 性能假设是否需要基准测试验证 |
输出
- 自动检测 Issue 编号(从分支名或 issue 上下文)
- 生成 HTML 格式笔记文件
- 保存到
docs/issue#NNNN.md - 如已存在该 Issue 笔记,提示是否追加或覆盖
定位
/note-it 位于工作流中 /review-it 和 /ship-it 之间,作为提交前最终检查点——确保实现意图被完整记录,方便后续维护者理解代码背后的决策逻辑。
15. Bonus: /walkthrough — 交付前走查
/walkthrough 在实现、验证和 /review-it 都完成之后、/ship-it 之前,产出一份可以直接交给 reviewer 的走查文档:说清改了什么、真的跑过什么、打印了什么,并用视觉证据证明 demo 路径确实走通。它的重点是证据而不是断言——diff 说明代码长什么样,走查说明你实际运行了什么、看到了什么。
触发方式
# 直接输入
/walkthrough

# 或使用触发词
走查:为 user-auth 生成交付前走查
交付前走查:整理这次改动的验证证据和 PR 草稿
走查文档的四个部分
| 部分 | 内容 | 要点 |
|---|---|---|
| 1. 变更摘要 | 面向没看过这份改动的人描述 diff | 3–6 条:做了什么、关键文件与组件、对应哪条需求 / Issue |
| 2. 验证步骤 | 真正跑过的命令与真实输出 | 贴出确切命令和输出(保留 pass 数、截断噪声);UI 场景按「操作 → 观察结果 → 通过/失败」逐条记录 |
| 3. 视觉证据 | demo 路径的截图或短视频 | 2–4 张证明主路径(前 → 操作 → 后),而不是截图堆 |
| 4. 评审闸门 | 合并前要核对的东西 | diff stat 与文件清单、高风险提示、可直接粘贴的 PR 正文、合并清单 |
输出
- 格式:Markdown,单个文件
- 保存到
tasks/walkthrough-<feature>.md(tasks/是这套技能集默认的工作产物目录) - 文件名用 kebab-case;功能名优先取用户给的名字,其次从分支名或
tasks/prd-*.md/spec-*.md推导,都没有就问用户 - 图片默认用相对路径(
)并随文件一起提交:文件小、diff 可读 - 只有文档必须独立存在时(贴进聊天、issue 评论等图片不会跟着走的地方)才用 base64 data URI,并说明用了哪种模式
定位
/walkthrough 是 /note-it 的兄弟:两者都在评审之后、交付之前产出工件,但管的不是同一件事——/note-it 记录设计理由(为什么这么做),走查记录证据(跑过什么、看到了什么)以及一份合并前清单。它记录门禁输出,但不替代项目自己的门禁;没有验证过的步骤要如实写成未验证或阻塞,绝不写成已通过。
16. Bonus: /code-to-spec — 逆向生成规格文档
/code-to-spec 分析一个既有项目的代码、配置、测试和结构,反向生成一份完整的 SPEC(规格)文档。输出可用于重建项目、新人入职或对比实际实现与预期设计。
触发方式
# 直接输入
/code-to-spec

# 或使用触发词
生成设计文档:分析当前项目并生成 SPEC
reverse spec:逆向工程这个项目的规格
生成规格文档:为 src/ 目录生成技术规格
分析深度
| 级别 | 内容 | 适用场景 |
|---|---|---|
| Overview | 架构 + 技术栈 + 核心功能 | 快速了解项目,~5 分钟 |
| Standard(默认) | + API 合约 + 数据模型 + 配置 + 依赖 | 全面理解项目 |
| Deep | + 内部模块交互 + 错误处理 + 测试覆盖 | 准备重构或重写 |
SPEC 文档结构(12 章节)
| # | 章节 | 内容 |
|---|---|---|
| 1 | Overview | 目的、核心功能、架构风格 |
| 2 | Tech Stack | 语言、框架、数据库、构建、测试、部署 |
| 3 | Project Structure | 目录树 + 各目录职责注释 |
| 4 | Data Model | 核心实体、字段、关系、状态流转 |
| 5 | API Surface | 端点/命令/函数表 + 请求响应 Schema |
| 6 | Configuration | 环境变量、配置文件、Feature Flags |
| 7 | External Dependencies | 第三方服务、基础设施、失败影响 |
| 8 | Business Rules | 不变量、校验规则、业务逻辑约束 |
| 9 | Non-Functional | 性能、安全、错误处理模式 |
| 10 | Testing Strategy | 测试框架、覆盖模式 |
| 11 | Known Gaps | 不确定项、假设、无测试区域 |
| 12 | Appendix | 依赖图、本地环境搭建步骤 |
工作流程
- 确认分析范围(整个仓库 / 指定目录 / 特定方面)和深度级别
- 扫描项目:识别入口点、目录结构、依赖图、API 路由、数据模型
- 提取业务规则:从校验函数、Guard Clauses、测试断言中推导
- 合成生成 12 章节 SPEC 文档
- 展示供审阅,根据反馈迭代调整
- 保存到
docs/SPEC.md或用户指定位置
17. Bonus: /smell — 架构坏味道检测
/smell 分析代码库中的架构反模式、代码坏味道和算法复杂度热点。输出详细的 Markdown 报告,包含严重级别、证据和重构路线图。
如何调用
# 直接输入
/smell

# 或使用触发短语
代码坏味道检测:找出代码坏味道
架构审计:检测架构反模式
复杂度扫描:分析代码复杂度
检测类别(8 大类,50+ 坏味道)
| 类别 | 示例 |
|---|---|
| 架构 | 大泥球、分布式单体、贫血模型、CQRS 滥用、层边界违反 |
| 耦合 | 循环依赖、内容耦合、公共耦合(全局状态)、印记耦合 |
| 内聚 | 上帝对象、霰弹式修改、依恋情结、数据泥团 |
| 设计 | 抽象泄露、静态粘连、服务定位器滥用、SOLID 违反 |
| 代码 | 重复代码、长方法、基本类型偏执、魔数、死代码 |
| 测试 | 零测试覆盖、测试-实现耦合、不稳定测试 |
| 命名 | 模糊命名、命名不一致 |
| 复杂度 | 嵌套循环 (O(n²))、N+1 查询、重复线性扫描、循环内排序、渲染重复计算 |
报告结构
- 执行摘要与整体健康评估
- 检测到的架构风格 vs. 期望风格
- 按严重级别分类的发现(严重 / 警告 / 建议)
- 依赖图分析与模块健康评分卡
- 8 大类坏味道分布统计
- 重构路线图(立即可做 / 短期 / 长期)
18. Bonus: /loop-it — 自动化 Issue 批量实现循环
/loop-it 获取所有打开的 GitHub Issue,解析依赖顺序,一次一个 Issue 内联实现(读需求 → 写代码 → 跑门禁自证),只在该 Issue 自己的分支上 commit(不 push、不开 PR)。批末把各分支汇总成一条批次分支(failed 的分支不并入),只做一次 /review-it、一次 /walkthrough 与一次 /ship-it。进度持久化到 .loop-state.json,崩溃或中断后可从断点恢复。
如何调用
# 直接输入
/loop-it

# 或使用触发短语
批量实现: 实现所有issue
循环实现: 批量实现
恢复循环: resume loop
核心特性
- 前置检查 — 验证 gh 认证、git 状态、远程可达性、工作树清洁度
- 依赖拓扑排序 — 解析 Issue 正文中的依赖关系,按拓扑顺序处理
- 检查点恢复 — 每次状态变更写入
.loop-state.json,崩溃后可断点续传 - 结构化错误恢复 — 10 类错误(构建、测试、lint、合并冲突、CI、认证、限流等),每类有独立恢复策略和重试上限
- 分支卫生 — 每个 Issue 独立分支
feat/issue-N-desc,只在自己的分支 commit(不 push);批末汇总成批次分支,failed 的分支不并入且保留 - 依赖阻塞 — 依赖的 Issue 未 shipped 时自动跳过并标记 blocked
- 进度可观测 — 每个 Issue 后输出结构化进度(已交付/跳过/阻塞/失败/剩余)
流水线集成
# 从 PRD 到代码交付的完整流水线
/prd → /prd-to-spec → /to-issues → /loop-it
                                               │
                                               └→ 每个 Issue:内联实现 → 门禁自证 → commit(× N)
                                                  批末 ×1:汇总批次分支 → /review-it → /walkthrough → /ship-it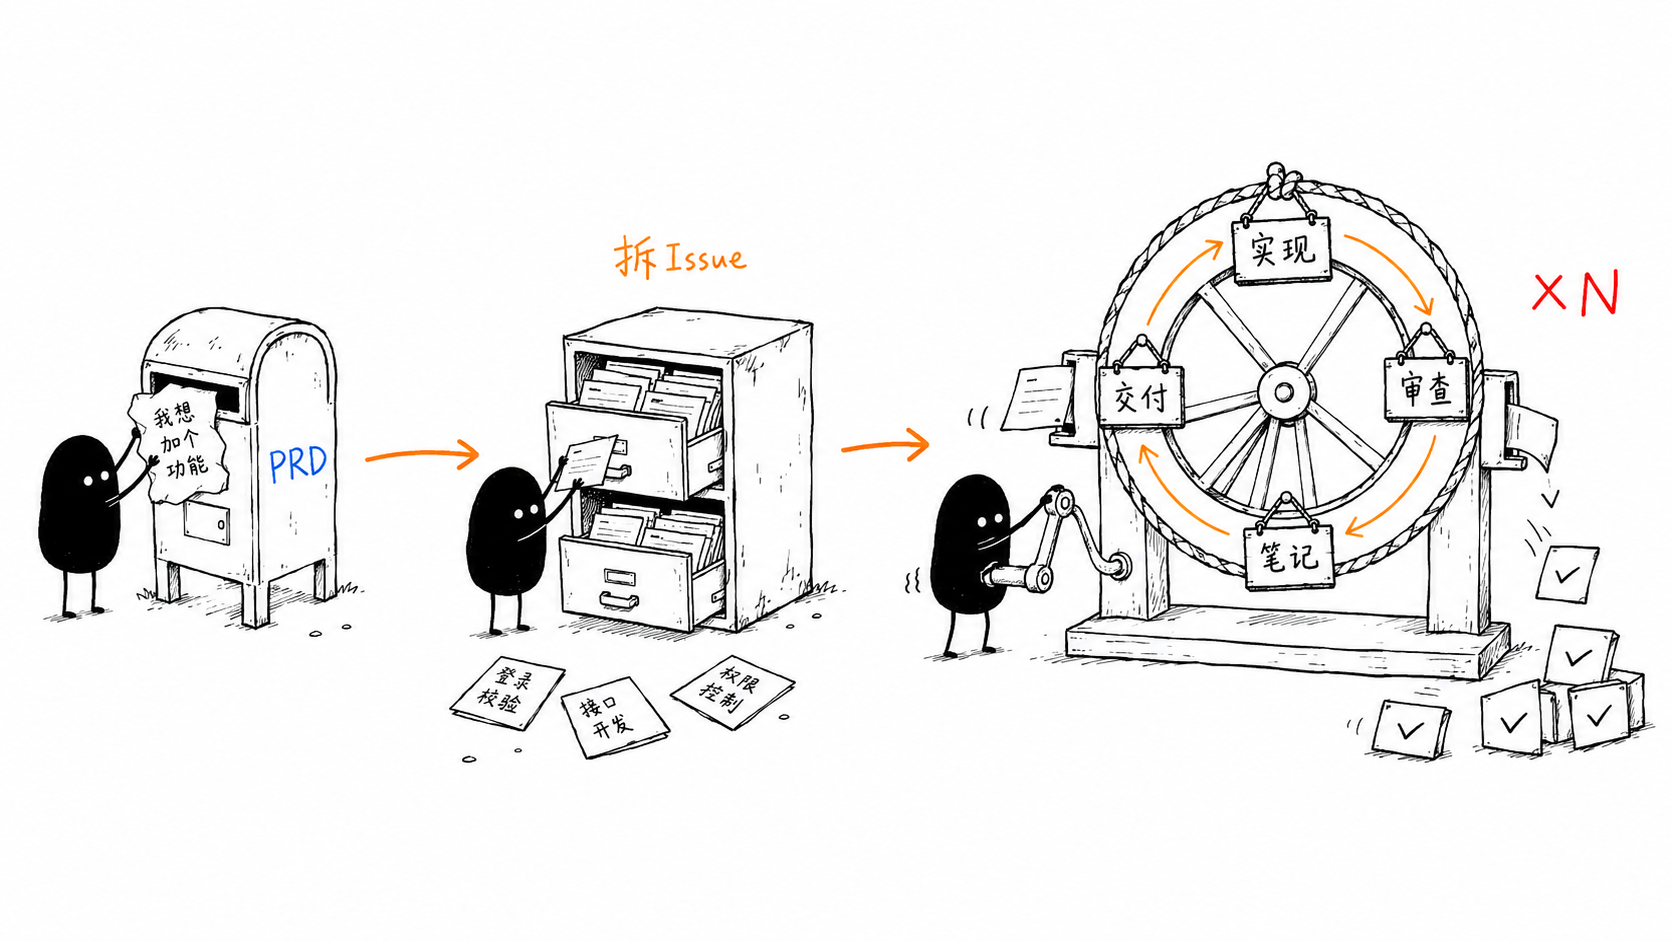
.loop-state.json 添加到 .gitignore。如果循环崩溃,再次运行 /loop-it 即可检测状态文件并恢复。
19. Bonus: /to-design — PRD 转设计文档
/to-design 把一份 PRD(或一个粗略想法)转化为 设计文档(design doc),文风借鉴 Go 官方提案:朴素的语言、具体的示例,以及最重要的——诚实地交代为什么选这个方案而不是别的。
/to-design 定方向,再 /prd-to-spec 落契约。
如何调用
# 直接输入
/to-design tasks/prd-priority-system.md

# 或使用触发词
生成设计文档:为优先级系统写一份 design doc
prd转设计文档:基于 prd-user-auth.md
什么时候用
- 已有 PRD,但在动手前需要先决定怎么建
- 方案有真实取舍,希望把它们记录下来供讨论
- 改动有风险、破坏性强或难以回退(设计文档会提前逼出兼容性讨论)
- 多人需要在工作分散开之前就方向达成一致
- 想留下一份"为什么选 X、否决 Y"的持久记录——即使方案最终被否决
设计文档结构(源自 5 篇 Go 官方提案)
| 章节 | 作用 |
|---|---|
| Abstract / 摘要 | 一段话讲完全文,并埋入最重要的那个承诺(如向后兼容) |
| Background / 背景 | 用具体例子或真实 bug 代码讲清"痛在哪",量化而非堆形容词 |
| Design / 设计 | 主体。声明 + 示例 + 边界三件套,从简到繁渐进式教学 |
| Rationale / 取舍 | 最关键章节:主动列出被放弃的备选方案及放弃原因 |
| Compatibility / 兼容性 | 凡破坏性变更正面承认,诚实列出代价与渐进迁移路径 |
| Implementation / 实现 | 用数据和工具支撑"可落地",而非空喊"风险可控" |
| Appendix / 附录 | (可选)完整 API、端到端示例、FAQ |
工作流程
- 定位输入(PRD 文件 / Issue 链接 / 直接粘贴 / 仅描述想法)
- (可选)扫描代码库:现有模式、约束、可引用的真实痛点代码
- 找出真正的"决策分叉点",提 3-5 个澄清问题
- 按 Go 提案风格生成设计文档
- 展示供审阅,重点看 Rationale 与 Compatibility
- 保存到
tasks/design-[feature-name].md
20. Bonus: /graph — 任务图并发实现
/graph 把一个任务(或 PRD / SPEC / Issue 集合)转化为有向无环图(DAG),按依赖关系分层为若干超步(wave),然后对每一层中相互独立的节点并发实现:每个节点由一个 subagent 在独立的 git worktree 中内联实现并 commit 到自己的分支;层与层之间用栅栏(fan-in barrier)汇聚——泄漏检查、只合并 shipped 的节点、在集成后的树上跑门禁,然后评审一次、走查一次、ship 一次,并动态重规划下一层。
/loop-it 是严格串行的——单个 worktree,一次处理一个 Issue;/graph 是它的并行版本——把同一层里所有独立节点一次性 fan-out 出去并发实现。当 DAG 中存在真正的并行度(相互独立的子系统)时用 /graph;当节点大量共享文件或必须串行保证安全时用 /loop-it。
设计思想借鉴了当下热议的 graph engineering、LangGraph 的 StateGraph / Pregel-BSP 超步模型,以及动态工作流(dynamic workflow)的编排理念。
如何调用
# 直接输入
/graph tasks/prd-url-shortener.md

# 或使用触发词
并发实现:把这些 issue 变成任务图并行实现
任务图:build a graph 并发跑
核心概念(借自 LangGraph / graph engineering)
| 概念 | 含义 |
|---|---|
| 节点 Node | 一个可独立实现的工作单元(一个 issue / 子任务) |
| 边 Edge | 依赖关系:B 依赖 A → 边 A → B |
| 超步 / 波次 Wave | 依赖已全部满足的一组节点——并发执行 |
| Fan-out | 为当前波次的每个节点派发一个 subagent |
| Fan-in(栅栏) | 等待本波全部节点完成,再开始下一波 |
| 状态通道 | .graph_state.json——波次之间共享的检查点,可断点恢复 |
| 实时看板 | graph.html——浅色风格仪表盘,每次检查点从 .graph_state.json 重新渲染 |
| 动态重规划 | 一波结束后,若冒出新工作/新依赖则修订图 |
工作流程
- 拆解为节点 — 复用
/to-issues规则,每个节点含标题、依赖、验收条件、类型、scope_hint(预计触碰的文件) - 构建 DAG 并校验 — 检测环(按 id 打破)、悬空依赖、scope 冲突
- 拓扑分层 — Kahn 算法分层为若干 wave;同波内改动同一逻辑的节点串行到下一波
- 渲染图并确认 — 输出分层计划 + Mermaid 图,等用户确认后才 fan-out
- 逐波执行 — fan-out(一个响应内派发多个 subagent = 并发)→ fan-in 栅栏 → 汇聚、更新状态、动态重规划
核心特性
- Worktree 隔离(强制) — 每个节点独占一个 git worktree,并行编辑互不污染工作树
- Fan-in 栅栏(强制) — 上一波全部节点完成、且波级集成结束后,下一波才启动(BSP 语义)
- scope 冲突串行化 — 无依赖但改同一逻辑的节点自动分到不同波次;共享的"接线文件"(router/main)例外,不因此串行全图
- 动态重规划 — subagent 通过
NEW_WORK:行上报新工作,栅栏处修订图并重新分层 - 失败阻塞下游 — 某节点失败则其所有依赖节点标记 blocked 并跳过
- 断点恢复 — 每波写入
.graph_state.json,崩溃后按波边界恢复;同时重新渲染graph.html(浏览器打开后每 5s 自动刷新,实时跟踪波次、节点状态与进度) - 并发上限 — 默认 3–4 个并发 subagent,避免限流与合并冲突
并发执行图
# 每波:fan-out → fan-in 栅栏
Wave 0 (并发×3):  #1 建表   #2 缓存层   #3 日志工具
Wave 1 (并发×2):  #4 API (依赖 #1)   #5 CLI (依赖 #2)
Wave 2 (并发×1):  #6 集成 (依赖 #4,#5)

# 每个节点在自己的 worktree 内:
内联实现 → 门禁自证 → commit 到自己的分支

# 每波末(只做一次):
泄漏检查 → 只合并 shipped 节点 → 集成后跑门禁 → /review-it → /walkthrough → /ship-it
流水线集成
/prd → /prd-to-spec → /to-issues ┬→ /loop-it  # 串行:一次一个节点
└→ /graph # 并行:整波一起跑nodes.json、.graph_state* 和 graph.html 加入 .gitignore(检查点用通配而不是列名字:默认名、改名前的 .graph_state、按次起的 --state .graph_state-prd015、以及写盘时的瞬时 .tmp 全都覆盖;nodes/graph 若用了非默认名,照原样补上),并在第一波之前提交这条忽略规则——/graph 的泄漏检查要求共享检出干净,未提交的 .gitignore 改动会让编排器把自己当成泄漏。派发 subagent 必须在同一个响应内发出多个调用才是并发——分成多个响应会退化为串行。
21. Bonus: /understand — 交互式变更审阅
/understand 把你刚生成的改动(通常是 AI 写的)变成一个单文件、可交互的审阅网页,帮你在审查或交付前真正吃透这次改了什么。它扫描仓库里未提交 / 分支变更,生成一个浅色主题的两栏页面:左侧是按真实项目布局排列的变更文件树,右侧是所选文件的语法高亮 diff,并在右侧边栏逐段给出相关单位需求与代码解释。
如何调用
# 直接输入
/understand

# 或使用触发短语
review 这次改动:解释一下这批新生成的代码
解释代码:带我过一遍刚生成的变更
页面构成
| 区域 | 内容 |
|---|---|
| 左侧文件树 | 按真实项目结构列出变更文件,含每文件 +/− 行数与 A/M/D/R 状态。该栏宽度可拖动调整(双击分隔条恢复默认)。 |
| 右侧 diff | 语法高亮 diff,增删与未变更代码明显区分,行号为文件真实行号。 |
| 右侧边栏 | 逐段卡片:对应单位需求(推测时标灰色「推测意图」)+ 大白话代码解释;点击可定位并高亮闪动对应代码行。 |
工作流程
- 扫描变更:已提交(base..HEAD) + 已暂存 + 未暂存 + 未跟踪新文件,基线为与主分支的 merge-base
- Agent 通读每处改动,再逐段撰写需求 + 解释注释
- 渲染出单文件
.understand/report.html并在浏览器打开
定位
/understand 是 /review-it 的理解型搭档:/review-it 负责发现并修复问题,/understand 则帮你在决定采纳前,看清新生成代码背后的意图与理由。
.understand/ 是产物目录,建议加入 .gitignore 以免误提交。解释与需求始终以中文产出。
22. Bonus: /ask-flow — 不知道该用哪个技能
/ask-flow 是整套技能集的入口:你想不起来这么多技能各自管什么,所以问。说清你现在的处境(一个还没成形的想法、一堆进来的 issue、一段调不通的代码、一次漫长的实现),它给你该敲的下一步,以及那一步里哪些决定得你来拍。
触发方式
# 直接调用
/ask-flow

# 或直接问
该用哪个技能
这套流程怎么走
路由覆盖
- 主线:
/prd→/prd-to-spec(复杂时)→/to-issues→ 岔口(真并行/graph/ 串行/loop-it/ 单单元/implement)→ 内联实现 → 门禁自证 →/review-it→/ship-it;需要留档就补/note-it,交付前走查补/walkthrough - 旁路:有 bug 走
/diagnose,外面进来的原始条目走/triage,先把行为定下来走/test-first,正在解 merge / rebase 走/conflict - 只建议,不执行:不会替你 grill 需求、写 spec、改文件,也不会顺手把你刚问的那个技能跑起来
- 自报缺口:维护规则要求任何技能新增 / 改名 / 删除后都回来重读并更新这份路由,以及两份 README 与这两份 HTML 指南——说谎的路由比没有路由更糟
/ask-flow 标了 disable-model-invocation:不在模型目录里,模型不会主动挑它,只有你敲命令时才加载。它还带一份 agents/openai.yaml(policy.allow_implicit_invocation: false)。
23. Bonus: /triage — 外部 issue 分诊
/triage 处理从外面进来的原始条目:bug 报告、用户反馈、别人提的需求。它先复现 / 理解,再给每条定一个角色,并把 ready 的补成 agent 可执行的卡片。/to-issues 产出的卡片不要 triage——那些已经 agent-ready。
角色(每条最后必须落到一个)
| 角色 | 含义 | 动作 |
|---|---|---|
ready | 复现 / 需求清楚,验收条件写得出来 | 补全正文(复现步骤、期望、验收条件、影响面),交给主线 |
needs-info | 缺关键信息,现在无法判断 | 按模板发一条评论要信息 |
bug-confirmed | 确实是 bug,但根因未定 | 记下症状与最小复现,转 /diagnose |
duplicate | 已有同一条 | 评论指路 → 关闭 |
wontfix | 明确不做 | 评论写清理由(对应哪条产品边界)→ 关闭 |
处理一条
- 先复现 / 先理解:按报告里的步骤重现;重现不了就明确说「我按 X 复现不了」,不要假装
- 判断影响面:影响谁、会不会坏数据、有没有绕过办法、是不是老版本才有
- 补成 agent-ready 的卡片:正文要写到「一个不共享本次对话上下文的子代理也能独立开工」——复现步骤、期望行为、验收条件、涉及文件 / 模块、明确的非目标;这条标准与
/to-issues一致 - 留痕:每条处理完在那个 issue 上留一条评论(角色 + 理由 + 下一步),不要只改标签;整批处理完把新增的
ready/needs-info/wontfix数量报给用户
ready 的条目交回主线——一串有依赖关系的用 /loop-it,互不共享文件的用 /graph,只有一个单元就用 /implement。
24. Bonus: /diagnose — 排障循环
难 bug、偶发 flake 与性能回归的纪律:在有一条已经在「这个」bug 上变红的命令之前,不许开始推理——直接跳到「我觉得是这里」正是这个技能要防的失败。它不做 /review-it / /ship-it,定位清楚后按单点改动回主线。
触发方式
# 直接调用
/diagnose

# 或直接说
排查一下这个偶发失败
这个性能回归怎么回事
循环
- 建立反馈环路:先拿到一条紧的 pass/fail 信号(在这个 bug 上会红)——失败测试、curl / HTTP 脚本、CLI + fixture、无头浏览器、重放捕获的轨迹、一次性 harness、属性 / 模糊测试、二分 harness、差分环路。判据:能变红、确定、秒级、可无人运行
- 复现 + 最小化:确认红出来的就是用户说的那个失败,再砍到「去掉任何一个剩余元素都会变绿」
- 3–5 条可证伪假设:每条写出「如果 X 是原因,那么改 Y 会让 bug 消失 / 改 Z 会更严重」;写不出预测的是感觉。排序后的清单先给用户看(他们常有领域知识能瞬间重排)
- 一次只改一个变量地埋点:探针都要对应某条预测;优先级是调试器 / REPL > 有目标的日志 > 绝不「全打日志再 grep」。每条调试日志带唯一前缀(如
[DEBUG-a4f2]),收尾一次 grep 全清。性能回归先建基线测量再二分 - 在正确的接缝上补回归测试,再修:测试要能在调用点复现真实的 bug 模式;没有正确接缝本身就是结论(记下来,当成一条新 issue 走主线)
- 收尾清单:原始复现不再出现、回归测试通过(或「无正确接缝」已记录)、所有
[DEBUG-...]埋点已清除、一次性原型已删除、最终成立的那条假设写进 commit / PR 说明
/graph。定位清楚之后按单点改动回主线:/implement → 项目门禁 → /review-it → /ship-it。
25. Bonus: /conflict — 解 merge / rebase 冲突
/conflict 解进行中的 git merge / rebase 冲突:先查清两边意图,再逐 hunk 解,跑项目门禁,把这次操作做完。永远解,不 --abort。
步骤
- 看清现状:
git status、git log --oneline --graph -10、列出冲突文件;确认这是 merge 还是 rebase、从哪分出来的、这次合并要达成什么 - 找出每处冲突的原始意图:读两边的 commit message、看对应的 PR 与 issue、必要时 grep 调用方——不要只看哪边新、哪边大就选哪边
- 逐个 hunk 解:能同时保留两边意图就都保留;真的不兼容时,选与本次合并目标一致的那一边,并把这个权衡写进 commit message,绝不发明新行为
- 跑项目门禁:至少构建 + 测试;判据是合并后的树自己通过门禁,而不是「两边合起来看起来对」
- 收尾:
git add全部冲突文件,把这次操作做完(rebase 时git rebase --continue直到所有提交重放完),再把「哪边让了什么」写进 commit / PR 说明
/graph 的节点里解冲突时,冲突在该节点的 worktree 内,用绝对路径与 workdir=;在共享检出上解冲突时,解完确认 git status 除了这次合并没有别的脏东西——共享检出的干净是编排器做泄漏检查的依据。
26. FAQ
Q: 必须按顺序使用所有步骤吗?
不必。每个 Skill 都是独立的,可以单独使用。比如你已经有 Issue 了,可以直接从实现开始——单个单元走 /implement,串行走 /loop-it,并行走 /graph;代码已经写好,可以直接用 /review-it 审查。但完整走一遍流程能获得最好的效果。
Q: /goal 是什么?为什么不在 skills 目录中?
在 DSH 中,/goal 是命令而不是 skill,因此不在 ~/.agents/skills 中。它由人类在命令行输入,创建一个带自动续跑轮次的持久目标;这条能力的模型侧是 create_goal / update_goal,但 create_goal 只在顶层直接的人类回合执行——子代理、或正在编排的技能,都无法给自己铸造一个长期目标。而「实现 Issue」这一动作与它无关,由 agent 内联完成(见 Step 2: /implement · /loop-it · /graph)。
Q: 可以在非 GitHub 项目中使用吗?
可以。/to-issues 支持把 Issue 保存为本地 Markdown 文件。/review-it 只需要本地 git 仓库。/ship-it 目前依赖 GitHub(gh CLI)。
Q: /review-it 和手动 code review 的区别?
/review-it 是自动化的自查(self-review),在提交前发现明显问题。它分两轴报告:Spec 轴查这份 diff 有没有做「要求的事」(缺的 / 多做的 / 做错的,每条引用对应的验收条件),Standards 轴按 8 个维度查代码质量。两轴分开报告、不合并排序。它不替代团队 code review,而是在 PR 创建前提升代码质量,减少 reviewer 需要指出的低级问题。
Q: Issue 粒度应该多大?
每个 Issue 应该是一个 Agent 在单次会话中可以完成的工作量——通常是 1-3 个文件的变更,有明确的验收标准。这个粒度由 /to-issues 把关,拆完你可以调整。
Q: /prd-to-spec 是必需的吗?什么时候可以跳过?
不是必需的。/prd-to-spec 是一个可选步骤。PRD 说的是"做什么",SPEC 说的是"怎么做"。区别在于:AI agent 在实现阶段本身就具备"怎么做"的能力——它会自动分析代码库、理解现有架构和约定、在实现过程中做出合理的技术决策。换句话说,AI agent 就是一个活的 SPEC 引擎,不需要在纸面上先画一遍。
大多数中小型功能只靠 PRD → 内联实现就能很好地跑通。以下场景才值得多写一步 /prd-to-spec:
- 多人/多 agent 并行开发——需要共享技术约定,避免各自按不同方式实现
- 跨多个服务/模块的改动——架构决策影响面大,返工成本高
- 后期需要维护文档——需要一份正式的技术参考供团队查阅
- 合规/评审要求——组织流程强制要求设计文档
- PRD 写得太模糊——SPEC 可以用技术细节补足,降低 agent 的理解偏差
如果你的项目是单人开发、功能边界清晰、agent 已经能稳定理解项目结构的,跳过 /prd-to-spec 完全合理,甚至更高效。把它当成工具包里的可选武器,需要时再拿出来。
Q: /humanize-it 的 42 次迭代上限是怎么来的?
数字 42 并非迭代次数有特殊要求,而是向经典科幻小说《银河系漫游指南》(The Hitchhiker's Guide to the Galaxy)致敬的极客文化。在该书中,超级计算机经过 750 万年计算,得出了"生命、宇宙及一切的终极答案"就是 42。在编程界,这个数字非常流行,原因有二:
- 致敬科幻:作为程序员群体中广为人知的彩蛋,代表了终极的解答。
- ASCII 巧合:在 ASCII 编码中,42 对应的是星号
*。在计算机科学中,*经常被用作通配符,表示"任何事物"或"一切皆有可能"。因此,"终极答案是 42(*)"刚好契合了"任何你想要的答案"这一哲学梗。
实际使用中,大多数文档在 3-5 轮迭代后就能达标。迭代的核心是智能切换策略——当一种改写方式效果停滞时,自动换用另一种,三种策略组合使用可以互补覆盖不同类型的 AI 痕迹。
Q: /humanize-it 支持英文文档吗?
目前 /humanize-it 的三个子 skill 主要针对中文文本优化。humanizer-zh 的模式检测规则对英文也部分适用,但改写效果以中文为最佳。
Q: /insight-diagram 支持哪些图表类型?
/insight-diagram 支持 17 种图表类型,包括系统架构图、14 种 UML 图(类图、对象图、组件图、部署图、包图、复合结构图、剖面图、用例图、活动图、状态机图、序列图、通信图、定时图、交互概览图)、流程图和泳道图。输出为 HTML+SVG 格式,保存到 docs/ 目录。适用于任何软件项目。